Разработчики ИИ выявили «налог» на неанглийские языки при работе с чат-ботами
Коалиция CLEAR обнаружила, что обработка запросов на некоторых языках требует до 17 раз больше токенов, чем на английском, из-за чего растёт стоимость и время ответа.
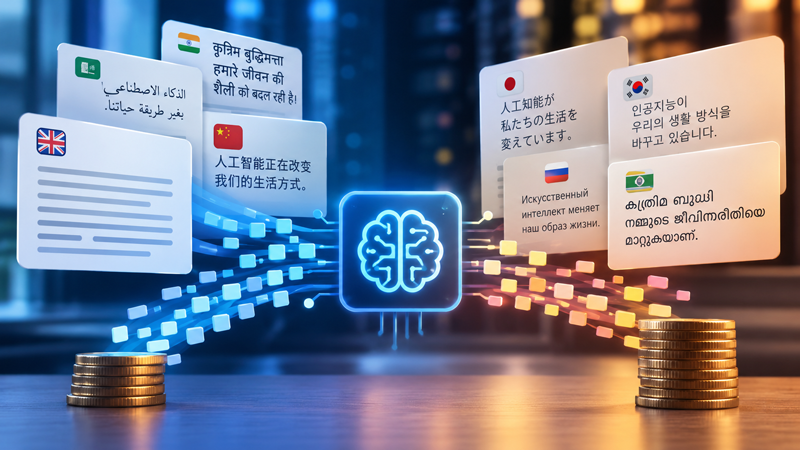
Коалиция за языковое равенство в исследованиях ИИ (CLEAR) опубликовала результаты исследования, показавшего, что стоимость и скорость обработки запросов к ИИ-системам существенно различаются в зависимости от языка общения. Разницу назвали «налогом токенизатора» (tokenizer tax).
Языковые модели обрабатывают не слова целиком, а токены — фрагменты текста, на которые алгоритм-токенизатор разбивает входные данные перед их анализом. Поскольку многие коммерческие ИИ-сервисы берут плату именно за количество токенов, язык, который разбивается на большее число фрагментов, обходится пользователю дороже при передаче одного и того же смысла.
Для проверки исследователи использовали корпус параллельных переводов FLORES-200, охватывающий около 200 языков. Среди 20 самых распространённых в интернете языков разница между наиболее и наименее «дорогими» в обработке вариантами составила от 1,5 до 5 раз в зависимости от модели. Когда выборку расширили до всех 200 языков, разрыв для отдельных моделей вырос до 17 раз. Так, фраза на малаялам — языке юга Индии — может потребовать 26 токенов против 13 токенов для эквивалентного английского текста.
По данным исследователей, строгой закономерности здесь нет: всё зависит от конкретного текста и контекста, хотя английский язык чаще всего оказывается в выигрышном положении. Особенно заметные сложности возникают у языков с письменностями, слабо представленными в обучающих данных токенизаторов — это бирманский, тибетский, кхмерский, лаосский языки, а также письменности тифинаг и ол-чики. При этом редкость языка не всегда означает проблему: например, астурийский получает преимущество благодаря латинскому алфавиту и схожести с другими романскими языками.
Помимо прямых расходов, разница в токенизации ограничивает доступный объём контекста — места для документов, истории переписки и других данных в рамках одного запроса. При одинаковом лимите токенов пользователи более «дорогих» языков располагают меньшим пространством для работы. Кроме того, дополнительные токены увеличивают вычислительную нагрузку и задержку ответа модели.
В качестве решений специалисты CLEAR предлагают расширять в обучающих выборках долю качественных многоязычных данных и целенаправленно разрабатывать токенизаторы с учётом особенностей разных письменностей. При этом одного увеличения объёма данных недостаточно — необходимо также совершенствовать сами алгоритмы разбиения текста.
Почему это важно
Если двадцать лет назад цифровое неравенство означало прежде всего ограниченный доступ к интернету, то с распространением ИИ-сервисов оно приобретает новую форму: носители менее распространённых языков платят больше и получают меньше за те же деньги при обращении к чат-ботам и другим ИИ-инструментам.
Это касается не только стоимости, но и качества использования технологий — меньший доступный контекст и более медленные ответы делают ИИ-системы менее удобными для миллионов людей, говорящих на языках, недостаточно представленных в обучающих данных разработчиков.
По материалам: 3dnews.ru