Gemma 4: Инновационная мультимодальная модель от Google DeepMind
Google DeepMind выпустила новую модель Gemma 4, обладающую уникальной архитектурой и мультимодальными возможностями. Модель обеспечивает высокую производительность при работе с текстом, изображениями и звуком.
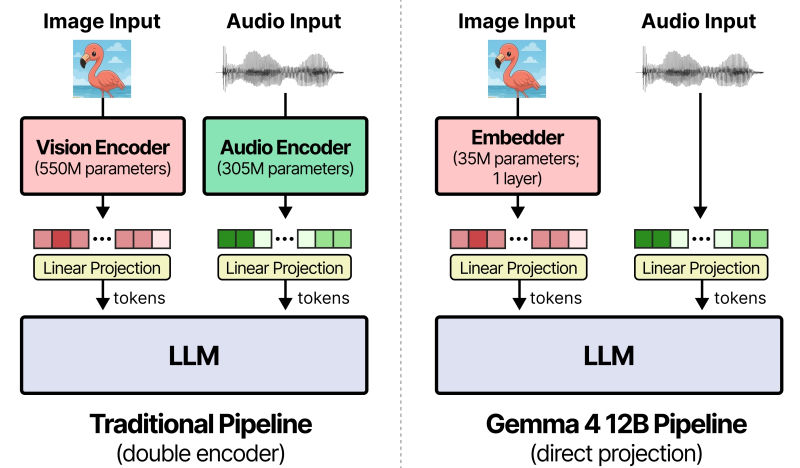
28 сентября 2026 года Google DeepMind анонсировала Gemma 4, новую модель из семейства больших языковых моделей. Gemma 4 12B имеет 11,95 миллиарда параметров и использует унифицированную бескодировочную архитектуру, что позволяет ей работать с текстом, изображениями и аудио. Для инференса требуется всего 16 Гбайт оперативной памяти, что делает ее доступной для использования в среде Unsloth Desktop (UD).
Данная модель отличается от классической архитектуры, которая требует специализированных кодировщиков для обработки различных форматов данных. Вместо этого Gemma 4 12B использует компактный модуль на 35 миллионов параметров для обработки изображений, разбивая их на фрагменты размером 48 × 48 пикселей. Эта система позволяет основной нейросети самостоятельно интерпретировать фрагменты, что значительно упрощает процесс обработки.
Обработка аудиопотоков в Gemma 4 12B также оптимизирована: звуковые данные разбиваются на фреймы продолжительностью 40 миллисекунд и напрямую отображаются в латентное пространство. Таким образом, модель стала первой генеративной моделью среднего класса с встроенными аудиовозможностями, что устраняет необходимость в отдельном декодере для звукового ввода.
Благодаря бескодировочной архитектуре Gemma 4 12B обеспечивает равнозначность текстового, визуального и звукового ввода, что критически важно для дальнейшего дообучения модели на специфических данных. Это позволяет избежать дополнительных сложностей, связанных с модификацией кодировщиков, что делает процесс дообучения более эффективным.
Модель доступна для загрузки в квантизации UD-Q4_K_XL, файл занимает 7,1 Гбайт. После загрузки пользователям необходимо настроить контекстное окно и активировать определенные опции, чтобы обеспечить оптимальное функционирование Gemma 4 12B. В ходе тестирования модель продемонстрировала способность к извлечению смыслов и формированию вопросов, хотя возникли и некоторые неточности в интерпретации данных.
По материалам: 3dnews.ru